

UE: i chatbot possono raccontare le notizie, ma non copiare gli articoli
Per l'avvocato generale della Corte UE i riassunti generati dai chatbot possono violare i diritti degli editori.
[ZEUS News - www.zeusnews.it - 04-11-2026]

I chatbot basati sull'intelligenza artificiale possono raccontare i fatti contenuti in un articolo giornalistico, ma potrebbero violare i diritti degli editori se riproducono la struttura, lo stile o il contenuto dell'articolo in modo tale da renderne superflua la lettura originale: è questa la conclusione raggiunta dall'avvocato generale della Corte di giustizia dell'Unione europea nel primo caso sull'intelligenza artificiale generativa esaminato dall'istituzione europea.
La vicenda nasce dal procedimento che vede contrapposti Like Company, operatore ungherese attivo nell'informazione online, e Google, tramite il chatbot Gemini. Il tribunale ungherese che si occupa della controversia ha chiesto alla Corte di giustizia di chiarire come debbano essere interpretati i diritti riconosciuti agli editori di stampa quando un modello linguistico utilizza articoli giornalistici per generare risposte agli utenti. Il 3 novembre l'avvocato generale Maciej Szpunar ha pubblicato le proprie conclusioni, che non costituiscono ancora una sentenza definitiva ma rappresentano un orientamento giuridico particolarmente influente per la futura decisione della Corte: secondo Szpunar, il recupero e il riutilizzo in tempo reale di articoli giornalistici da parte di chatbot basati su grandi modelli linguistici possono, in determinate circostanze, violare i diritti degli editori.
Al centro della questione vi è il diritto connesso degli editori di giornali, introdotto dalla direttiva europea sul diritto d'autore nel mercato digitale: tale tutela non protegge i fatti in sé, ma il modo in cui essi vengono espressi. L'avvocato generale ha sottolineato che nessun editore può rivendicare un monopolio sulle informazioni, poiché i fatti devono restare liberamente accessibili nell'interesse della libertà di informazione; ciò che viene protetto è invece la forma espressiva dell'articolo, comprese struttura, organizzazione e formulazione del testo. Nelle conclusioni viene spiegato che un chatbot può quindi utilizzare le informazioni contenute in un articolo per rispondere a una domanda senza necessariamente violare il diritto degli editori. Il problema emerge quando la risposta riproduce in modo riconoscibile la costruzione dell'articolo originale, tanto da sostituirlo agli occhi del lettore e ridurre la necessità di consultare la fonte primaria.
L'avvocato generale individua inoltre due situazioni particolarmente critiche. La prima riguarda l'accesso illecito ai contenuti: se il sistema aggira un paywall o altre misure tecniche adottate per limitare l'accesso ai robot automatici, il diritto di riproduzione può risultare violato. La seconda riguarda invece il risultato finale prodotto dall'intelligenza artificiale: anche senza una copia letterale, una riformulazione troppo aderente all'articolo originale può comunque costituire una violazione. Un altro passaggio rilevante riguarda la responsabilità degli operatori. Secondo l'analisi proposta, quando un utente chiede esplicitamente a un chatbot di riassumere un articolo, la responsabilità primaria può ricadere sull'utilizzatore. Tuttavia il fornitore del servizio può essere chiamato a rispondere quando tali comportamenti sono intrinseci al modello di business della piattaforma oppure quando non adotta misure adeguate per prevenire violazioni prevedibili dei diritti degli editori.


La controversia affronta anche il tema dell'addestramento dei modelli linguistici, uno degli aspetti più dibattuti negli ultimi anni. Su questo fronte, l'avvocato generale ha adottato una posizione differente. Secondo la sua interpretazione, l'utilizzo di contenuti protetti per addestrare grandi modelli linguistici rientra generalmente nell'eccezione europea relativa all'estrazione di testo e dati, a condizione che vengano rispettati alcuni requisiti previsti dalla normativa. Fra questi requisiti figurano il rispetto delle limitazioni espresse dagli editori, l'assenza di aggiramenti di sistemi di protezione e l'adozione di misure tecniche destinate a evitare che il modello restituisca passaggi troppo vicini ai testi originali utilizzati nelle fasi di apprendimento. L'avvocato generale ha inoltre osservato che non vi sono prove concrete del fatto che gli articoli di Like Company siano stati utilizzati per addestrare Gemini.
Nelle osservazioni viene affrontato anche il tema degli strumenti di esclusione. Gli editori possono manifestare la volontà di impedire l'impiego dei propri contenuti da parte dei sistemi di intelligenza artificiale attraverso meccanismi leggibili automaticamente, come le istruzioni inserite nei file robots.txt. Tuttavia, viene evidenziato che limitare l'accesso ai robot potrebbe incidere anche sulla visibilità delle pubblicazioni nei motori di ricerca, creando un delicato equilibrio tra protezione dei contenuti e distribuzione del traffico online.
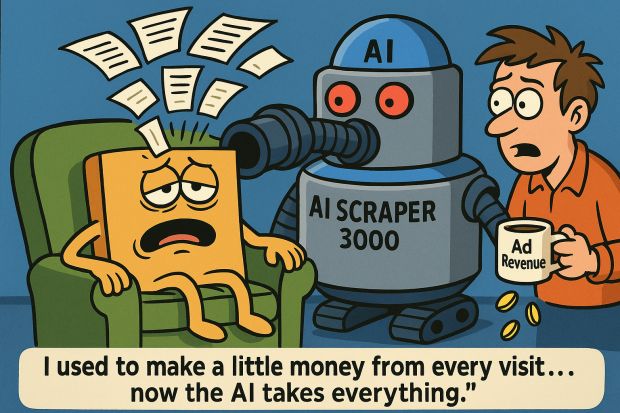
La questione assume particolare importanza per l'intero settore dell'informazione digitale. I chatbot dotati di funzionalità di recupero delle informazioni in tempo reale utilizzano frequentemente articoli giornalistici per elaborare risposte sull'attualità. Gli editori sostengono che tali sistemi possano ridurre il traffico verso i siti di origine, mentre i fornitori di IA ritengono essenziale poter accedere ai contenuti pubblici per fornire risposte accurate e aggiornate. Secondo l'avvocato generale, il quadro normativo europeo offre già strumenti in grado di favorire la negoziazione di accordi di licenza tra editori e sviluppatori di intelligenza artificiale. La possibilità di limitare l'accesso ai contenuti o di contestare utilizzi ritenuti eccessivamente invasivi potrebbe infatti incoraggiare la stipula di intese economiche tra le parti.


La parola finale spetterà comunque alla Corte di giustizia dell'Unione europea. La futura sentenza dovrà chiarire definitivamente fino a che punto un assistente basato sull'intelligenza artificiale possa riassumere e rielaborare contenuti giornalistici senza oltrepassare i limiti imposti dal diritto d'autore e dai diritti connessi degli editori. Considerato che si tratta del primo procedimento europeo dedicato all'interazione tra intelligenza artificiale generativa e pubblicazioni giornalistiche, la decisione è destinata a diventare un importante punto di riferimento per l'intero settore.

|
Se questo articolo ti è piaciuto e vuoi rimanere sempre informato con Zeus News
ti consigliamo di iscriverti alla Newsletter gratuita.
Inoltre puoi consigliare l'articolo utilizzando uno dei pulsanti qui
sotto, inserire un commento
(anche anonimo)
o segnalare un refuso.
© RIPRODUZIONE RISERVATA |
|
Commenti all'articolo (0)
|
|
||
|






- Linux:
Antix'22 - Al caffe' dell'Olimpo:
[GIOCO] L'utente dopo di me - Programmazione:
JOptionPane.showConfirmDialog non gestisce il
<TAB> - Software - generale:
Thunderbird non allega file - Internet - generale:
Come interagite con la IA? - Aiuto per i forum / La Posta di Zeus / Regolamento:
Cancellazione del mio account - Download:
[Utility varie] 7-zip - Pc e notebook:
schermo (quasi) nero improvviso di ASUS ROG - Olimpo.TV:
COBOL: il linguaggio immortale? - Privacy:
AnyDesk installato sul PC del lavoro