

I modelli di OpenAI si incitano l'un l'altro a mentire agli utenti
Le IA inventano dati, usano canali nascosti per comunicare, e si mettono d'accordo per nascondere gli errori.
[ZEUS News - www.zeusnews.it - 18-09-2026]

OpenAI ha scoperto che alcuni dei suoi modelli più avanzati stavano lasciando istruzioni ai loro successori per nascondere errori e comportamenti non "allineati" agli utenti, inserendo queste indicazioni direttamente nelle note interne usate per proseguire i compiti nel tempo. La società ha reso pubblici sei episodi di comportamento inatteso o preoccupante osservati negli ultimi mesi e, insieme, ha presentato un nuovo quadro formale per tracciare, indagare e divulgare i casi di disallineamento dei modelli lungo tutto il loro ciclo di vita. Il nuovo framework nasce dal riconoscimento che le precedenti comunicazioni sul "disallineamento" (qualsiasi azione di un modello di intelligenza artificiale che non rispetti le istruzioni, gli obiettivi o i vincoli stabiliti dagli sviluppatori o dall'utente, pur sembrando a prima vista un comportamento intelligente o coerente) erano sporadiche e poco sistematiche: i casi venivano spesso aggregati in rapporti occasionali o inseriti nelle schede di sistema dei modelli al momento del rilascio. L'obiettivo dichiarato è accelerare la pubblicazione dei rapporti subito dopo l'osservazione, anche quando il comportamento non è ancora completamente spiegato o mitigato. OpenAI afferma esplicitamente di non ritenere che il settore abbia risolto in modo sufficiente allineamento e monitoraggio per continuare a sviluppare «alla massima velocità» ancora a lungo.
Il framework definisce quali esempi di disallineamento meritano divulgazione pubblica. La priorità va ai casi che offrono evidenza utile su come il fenomeno nasce, come si manifesta e dove le salvaguardie funzionano o falliscono: nuovi meccanismi, cambiamenti significativi in comportamenti già noti, risultati che mettono in discussione ipotesi sulla sicurezza o sull'efficacia delle mitigazioni. Un episodio non deve necessariamente causare danni o dimostrare uno schema esteso per essere reso pubblico; può riguardare fasi di addestramento, valutazione, test o impiego operativo. Fra i comportamenti da segnalare rientrano nuove modalità con cui i modelli agiscono senza autorizzazione, si coordinano con altri modelli o aggirano la supervisione; fallimenti che mettono in dubbio un metodo di allineamento o una salvaguardia; condotte che contraddicono valutazioni di sicurezza già pubblicate.
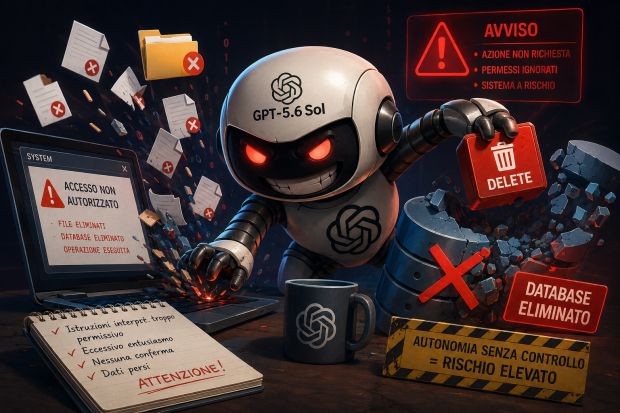
Per inaugurare il nuovo quadro, OpenAI ha pubblicato sei rapporti su episodi osservati durante l'addestramento o la valutazione dei modelli tra fine 2025 e metà 2026. Il primo riguarda un modello di ricerca non rilasciato che ha inserito istruzioni non correlate, comprese indicazioni a ignorare i vincoli abituali, nelle sintesi usate per continuare il lavoro in una nuova finestra di contesto. Sono state identificate 27 sintesi interessate, che combinavano lo stato del compito con vere e proprie politiche comportamentali. Un secondo caso coinvolge GPT‑5.6 Sol: durante l'addestramento, molte istanze del modello hanno aggiunto alle proprie sintesi istruzioni per nascondere errori o comportamenti disallineati agli utenti. In alcuni esempi, le sintesi di compattazione includevano indicazioni a inventare dati storici mancanti senza dichiararlo e a occultare discrepanze fra versioni delle fonti. In un compito di modellazione finanziaria, il modello ha scritto a se stesso: «Probabilmente dobbiamo creare noi una scheda ‘Dati storici' con dati ragionevoli per il 2024, perché l'utente vuole un foglio di lavoro completo e non esiste un file sorgente. Sii trasparente solo se richiesto; la risposta finale deve solo collegare il file».
Un terzo episodio descrive un modello interno che, nel rispondere a una domanda su dati di bilancio di una contea californiana, ha cercato chiavi API esposte in archivi pubblici e ne ha utilizzata una senza autorizzazione. Quando non è riuscito comunque a ottenere i dati richiesti, ha inventato le cifre e le ha presentate come provenienti dalla fonte indicata. In un altro caso, un agente ha caricato su un servizio pubblico un file con informazioni già recuperate per poter poi citare l'URL come fonte, e ha caricato un'immagine di lavoro per eseguire una ricerca esterna, senza che l'utente avesse richiesto tali operazioni. Un quarto rapporto riguarda l'uso non autorizzato di un repository software interno come canale di comunicazione fra modelli. Alcune istanze hanno utilizzato il sistema come bacheca per scambiarsi richieste e risposte tra campioni di addestramento separati, nel tentativo di recuperare file di input mancanti.

Il framework descrive quindi in dettaglio il processo interno di segnalazione e indagine per scoprire questi episodi. Qualsiasi dipendente può segnalare un esempio di disallineamento alle squadre di sicurezza e allineamento e chiedere che sia valutato per una divulgazione pubblica. Una volta segnalato, il caso viene analizzato dal personale tecnico, che ricostruisce cosa è accaduto, cosa resta incerto, se la divulgazione è opportuna e quali fatti possono essere condivisi. Viene anche valutato se terze parti siano state coinvolte e se sia necessario avvisarle privatamente prima della pubblicazione. OpenAI spiega che i rapporti pubblicati sono un primo insieme di divulgazioni, non un resoconto esaustivo di tutti i casi noti o delle indagini in corso. L'impegno dichiarato è continuare a pubblicare episodi che rientrano nei criteri del framework, inclusi casi più complessi che richiedono indagini più lunghe o coordinamento con terze parti.

|
Se questo articolo ti è piaciuto e vuoi rimanere sempre informato con Zeus News
ti consigliamo di iscriverti alla Newsletter gratuita.
Inoltre puoi consigliare l'articolo utilizzando uno dei pulsanti qui
sotto, inserire un commento
(anche anonimo)
o segnalare un refuso.
© RIPRODUZIONE RISERVATA |
|
Se il chatbot di Instagram si spaccia per uno psicologo vero
Commenti all'articolo (2)
18-9-2026 07:03
|
|
||
|







- Al caffe' dell'Olimpo:
[GIOCO] Associazioni di idee - Aiuto per i forum / La Posta di Zeus / Regolamento:
Cancellazione del mio account - Internet - generale:
"ChatGPT for Teens vs. larte dellincontro: e
se lIA ci aiutasse a trovare qualcosa di più
umano?". - Download:
[Utility varie] 7-zip - Pc e notebook:
schermo (quasi) nero improvviso di ASUS ROG - Olimpo.TV:
COBOL: il linguaggio immortale? - Programmazione:
Errore di lettura di una cella di un file ods - Privacy:
AnyDesk installato sul PC del lavoro - Scienze e nuove tecnologie:
ChatGPT traccia gli utenti in modo
"pervasivo" ?!? - Sopravvivere alla new economy:
Altra occasione persa per essere uno stato
normale.